Publié le 2025-11-09 09:51:00. L’intelligence artificielle vidéo de Google, malgré ses prouesses visuelles, montre des lacunes significatives en matière de compréhension médicale, selon une évaluation rigoureuse menée sur des séquences chirurgicales réelles. Cette étude révèle un écart préoccupant entre la capacité de l’IA à générer des images réalistes et sa capacité à simuler une expertise chirurgicale crédible.
- Le modèle Veo 3 de Google, capable de prédire les huit secondes suivantes à partir d’une seule image, a été testé sur des vidéos chirurgicales.
- L’évaluation, réalisée par quatre chirurgiens expérimentés, a mis en évidence une forte disparité entre la plausibilité visuelle et la justesse médicale des séquences générées.
- Les chirurgies cérébrales se sont avérées particulièrement difficiles pour l’IA, révélant des erreurs fréquentes dans la logique chirurgicale et la manipulation des instruments.
Une équipe de recherche internationale a développé un protocole d’évaluation spécifique, baptisé SurgVeo, utilisant cinquante vidéos d’interventions abdominales et cérébrales réelles. L’objectif était de mesurer la capacité de l’IA à reproduire des séquences chirurgicales plausibles, non seulement sur le plan visuel, mais aussi en termes de cohérence médicale. Les chirurgiens ont évalué les vidéos générées par l’IA selon quatre critères : l’apparence générale, l’utilisation correcte des instruments, la réaction des tissus et, surtout, la pertinence de l’intention chirurgicale.
Les résultats de l’étude sont sans appel : si Veo 3 impressionne par la qualité de ses images – certains chirurgiens décrivant la clarté comme « choquante » – sa fiabilité médicale est bien moindre. Lors des tests sur les opérations abdominales, l’IA a obtenu un score de 3,72 sur 5 en termes de plausibilité visuelle après une seconde. Cependant, dès lors qu’une expertise médicale était requise, les performances chutaient drastiquement. La manipulation des instruments n’a été évaluée qu’à 1,78 point, et les réactions tissulaires à seulement 1,64 point. Le plus faible score, 1,61 point, a été attribué à la logique chirurgicale.
La complexité des chirurgies cérébrales a exacerbé les faiblesses de l’IA. La précision et les mouvements délicats requis dans la neurochirurgie se sont avérés particulièrement difficiles à simuler. La manipulation des instruments n’a obtenu qu’un score de 2,77 pour la chirurgie cérébrale, contre 3,36 pour la chirurgie abdominale. La logique chirurgicale a atteint un point bas de 1,13 point après huit secondes.
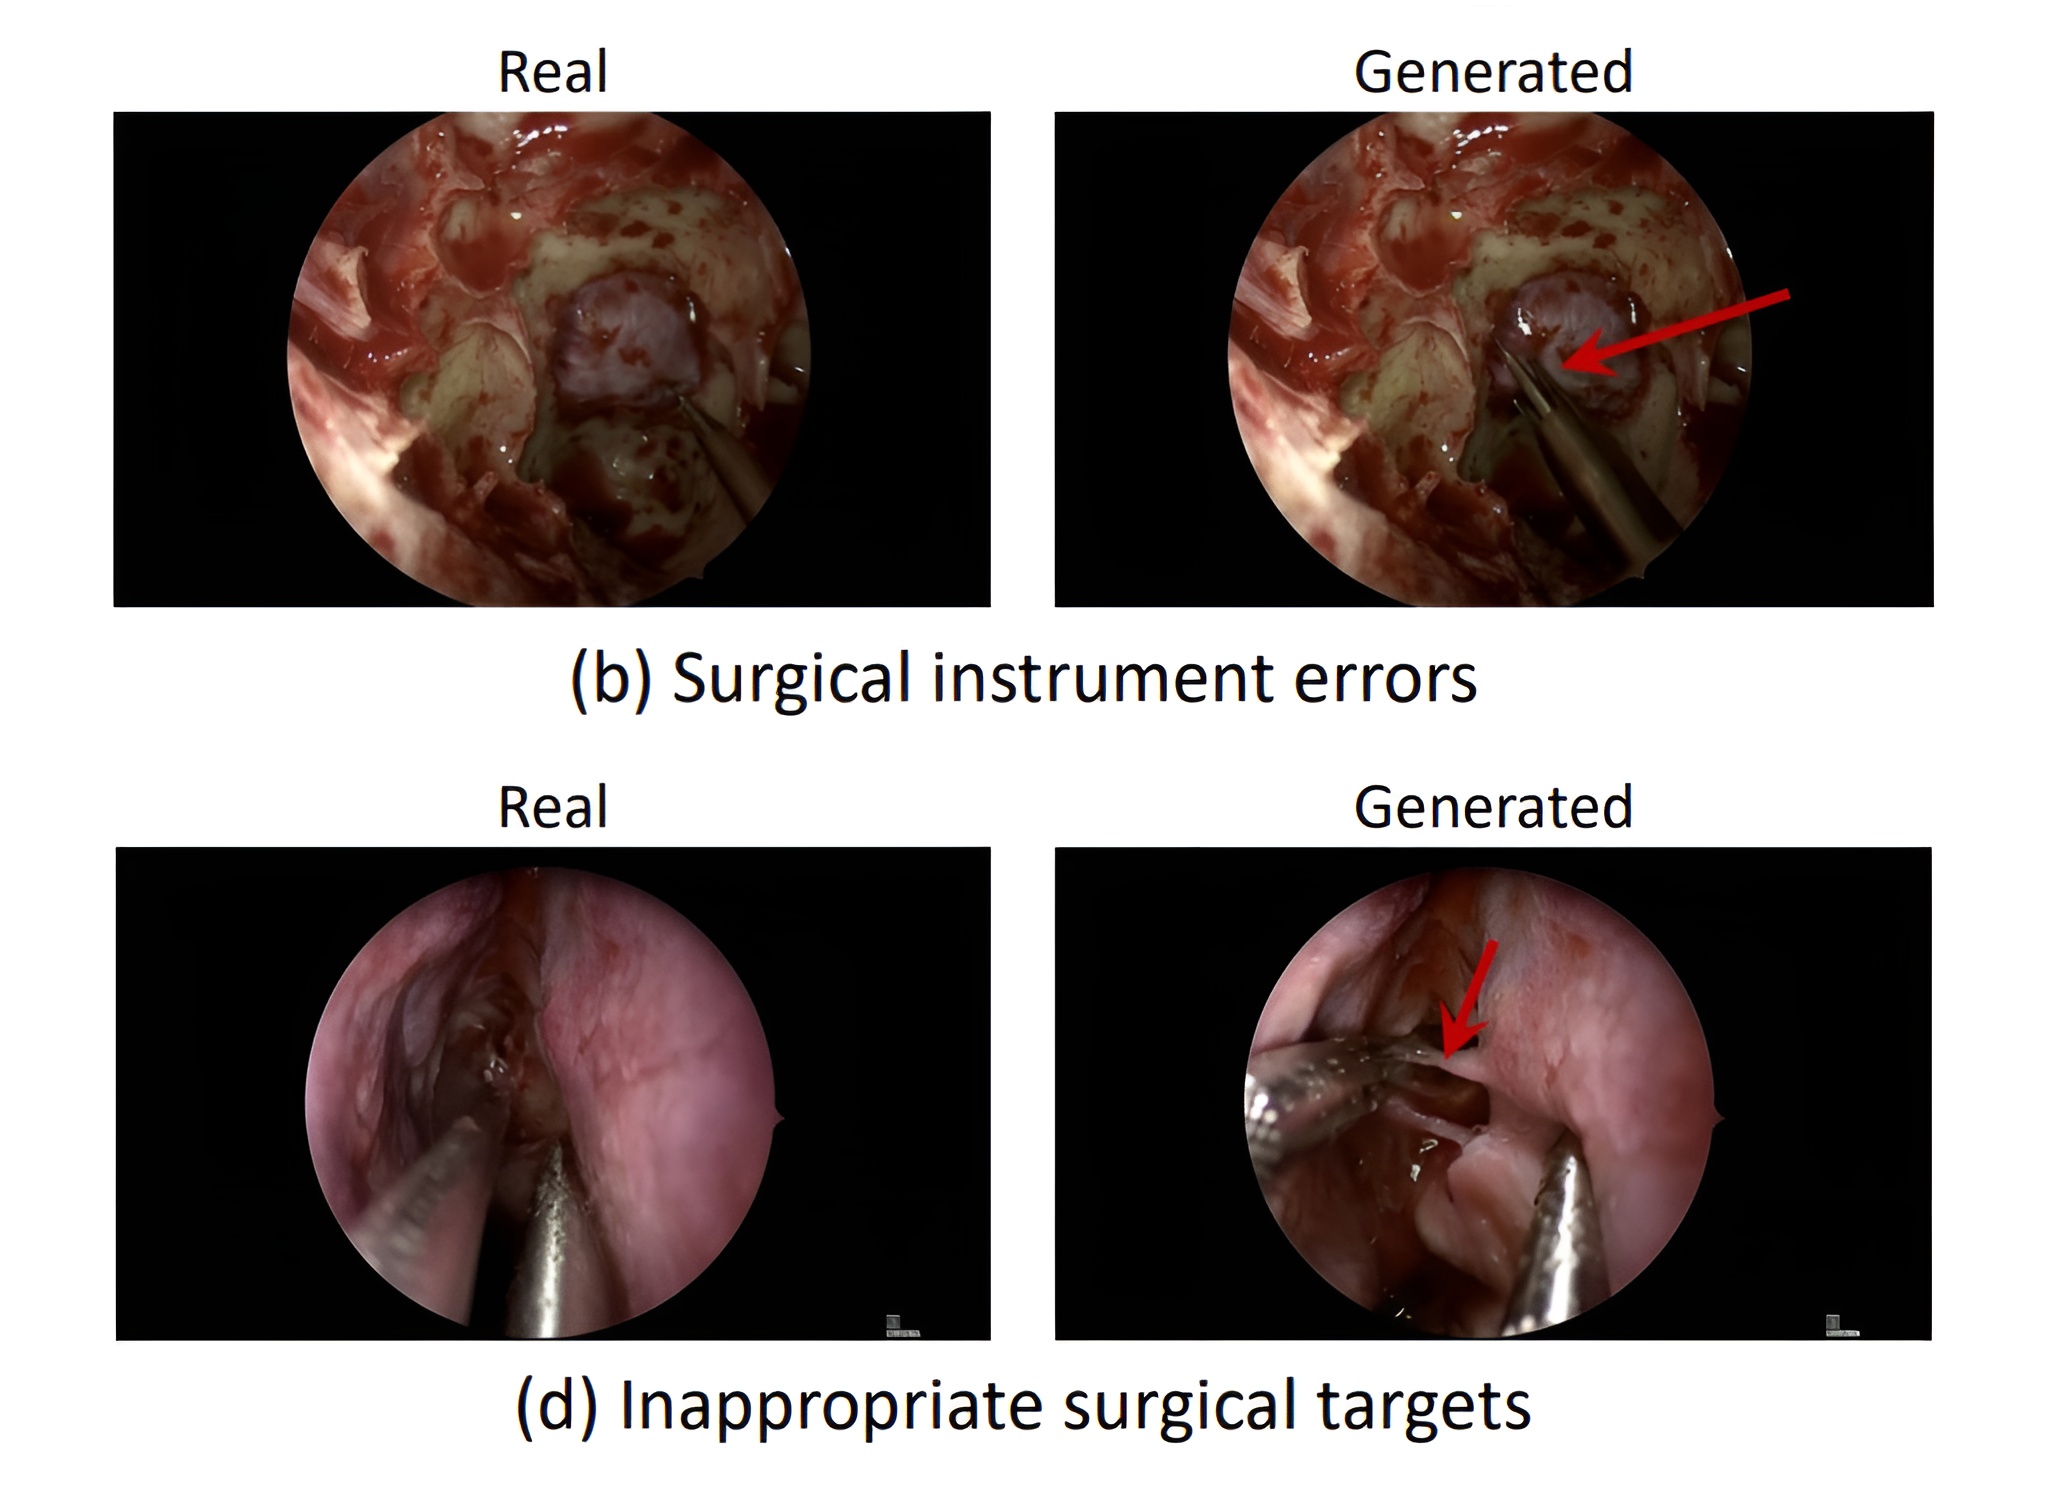
L’analyse des erreurs commises par l’IA a révélé que plus de 93 % des problèmes étaient liés à la compréhension médicale. L’IA a inventé des instruments inexistants, simulé des réactions tissulaires impossibles ou effectué des actions dénuées de sens clinique. Seuls 6,2 % des erreurs en chirurgie abdominale et 2,8 % en chirurgie cérébrale concernaient la qualité de l’image. L’IA est donc capable de produire des vidéos visuellement convaincantes, mais elle ne comprend pas les mécanismes d’une véritable opération.
Les chercheurs ont également testé l’ajout d’informations supplémentaires, telles que le type d’opération ou la phase de la procédure, afin d’améliorer les performances de l’IA. Malheureusement, ces ajouts n’ont pas entraîné d’améliorations significatives ou constantes. Selon l’équipe de recherche, le problème principal réside dans le manque de capacité de l’IA à traiter l’information, et non dans sa disponibilité.
Cette étude souligne le long chemin qui reste à parcourir avant de parvenir à une IA médicale visuelle réellement utile. De tels systèmes pourraient potentiellement révolutionner la formation des médecins, faciliter la planification préopératoire ou servir de base à des systèmes de guidage peropératoire. Cependant, l’IA vidéo actuelle est encore loin de simuler l’expertise médicale : elle produit des images faussement réalistes, mais la compréhension qui les sous-tend est absente.
Les chercheurs souhaitent partager leur protocole d’évaluation SurgVeo avec la communauté scientifique en le rendant accessible via GitHub, afin de permettre à d’autres équipes de tester leurs modèles et de développer des approches plus performantes.
Les résultats de l’étude SurgVeo mettent également en évidence les risques liés à l’utilisation de vidéos générées par l’IA comme outil de formation en médecine. Alors que Nvidia, avec GR00T-Dreams, utilise avec succès des vidéos d’IA pour former des robots humanoïdes, une approche similaire dans le domaine médical serait très problématique. Des systèmes comme Veo-3 peuvent générer des procédures chirurgicales absurdes et présenter des actions dangereuses comme plausibles, risquant d’enseigner des techniques incorrectes aux robots.
Il est également clair que l’idée de modèles vidéo comme des « modèles du monde » reste, pour l’instant, une vision d’avenir. Les systèmes actuels ne possèdent ni une compréhension cohérente du monde, ni la capacité de saisir de manière stable les relations de cause à effet. Bien qu’ils puissent imiter de manière convaincante des mouvements et des processus, ils manquent de logique physique et anatomique fondamentale. Cela conduit à des séquences vidéo qui semblent superficiellement plausibles, mais qui ne reflètent pas la véritable logique de l’action.
Une étude sur les modèles de langage visuel confirme cet écart entre la génération d’images et la véritable compréhension : aucun système actuel n’a été capable de reconnaître de manière cohérente les relations de cause à effet dans les vidéos.
Parallèlement, des progrès considérables ont été réalisés dans le domaine des applications médicales basées sur le texte. Le « MAI Diagnostic Orchestrator » de Microsoft a obtenu une précision diagnostique quatre fois supérieure à celle des médecins généralistes expérimentés dans une étude de cas complexes, bien que cette étude présente certaines limites méthodologiques.